Programmatic SEO с нуля: как я спроектировал структуру сайта на тысячи посадочных страниц
Содержание
- Проект — сервис международных пассажирских перевозок между городами Украины и Европы.
- Сначала я посмотрел реальную выдачу
- Список конкурентов я собирал из нескольких источников
- По конкурентам я собирал не только SEO-показатели
- Дальше я выгрузил лучшие страницы конкурентов
- Семантика помогла определить приоритет маршрутов
- После исследования я перешёл к архитектуре
- Сначала нужно было нормализовать города
- Основным SEO-объектом стал маршрут
- A → B и B → A — разные маршруты
- Все возможные пары городов заранее создавать не нужно
- Пользовательский поиск стал одним из источников новых маршрутов
- Новый маршрут становится полноценной сущностью
- Обратное направление остаётся отдельным
- Я отдельно защитил архитектуру от ручных дублей
- Добавление нового города тоже проходит проверку
- Параметры поиска я отделил от маршрута
- В sitemap должны попадать только чистые маршруты
- Четыре языка были заложены в архитектуру сразу
- Страны и города стали дополнительными уровнями структуры
- В итоге структура могла расти вместе с реальным спросом
- Эту модель можно перенести на другие транспортные проекты
- Создать новый маршрут — только половина задачи
Проект — сервис международных пассажирских перевозок между городами Украины и Европы.
Важный момент: часть изображений и данных в этом кейсе будет заменена или обезличена, так как по NDA я не могу использовать оригинальные материалы проекта. При этом я могу подробно описывать свою работу, принятые решения и саму архитектуру. Подход также применим к смежным транспортным тематикам.
Моя задача была с нуля спроектировать SEO-архитектуру, которая сможет масштабироваться вместе с количеством стран, городов и маршрутов. Основными SEO-страницами должны были стать направления город A → город B и отдельно город B → город A, плюс четыре языковые версии, страницы стран и городов.
Но основной смысл Programmatic SEO в этом проекте был не в том, чтобы взять список городов, перемножить их между собой и заранее получить десятки тысяч URL.
Я хотел построить систему, которая сможет расширять SEO-структуру вместе с реальным спросом.
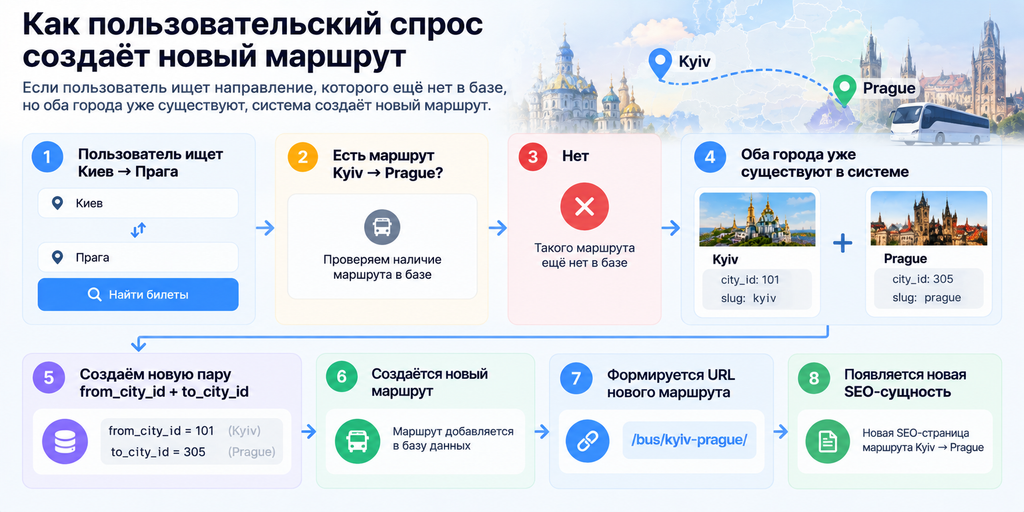
Если пользователь ищет направление, которого ещё нет в базе, но оба города уже существуют в системе, на основании этого поиска можно создать новый маршрут. После этого появляется новая сущность и новая SEO-посадочная, которая дальше подключается к общей автоматизации.
Но прежде чем проектировать такую систему, мне нужно было разобраться с рынком, реальной выдачей, конкурентами и спросом.
Сначала я посмотрел реальную выдачу
Для начала я определил около 10 основных запросов, которые напрямую описывали услугу проекта. По каждому запросу вручную собирал ТОП Google и смотрел, какие сайты действительно конкурируют за эту выдачу.
Так как проект международный, одной географии было недостаточно. Через Google Search — Geolocation & Language Change я менял страну, город, при необходимости более точную локацию и язык.
Это позволяло отдельно смотреть выдачу для нужного рынка и сравнивать её с другими странами.
Позже Google начал отдавать результаты через URL вида /goto. Чтобы не разбирать редиректы вручную, я использовал Goto URL Resolver и сразу видел конечные адреса страниц.
Для меня было важно получить реальную картину выдачи в конкретной географии, а уже после этого дополнять её данными SEO-сервисов.
Список конкурентов я собирал из нескольких источников
Дополнительно потенциальных конкурентов собирал через Serpstat. Он хорошо подходил для быстрого расширения первоначального списка, но автоматически принимать найденные сервисом домены я не стал.
Каждый сайт я открывал вручную и проверял, что он действительно делает. Даже при правильно выбранной тематике в список могли попадать домены, которые пересекались с проектом по семантике, но фактически предоставляли другую услугу.
В результате рабочий список состоял из сайтов, которые действительно находились в нужной выдаче Google, и дополнительных кандидатов из Serpstat, которые прошли ручную проверку.
То есть SEO-сервис помогал быстрее собрать кандидатов, но финальный список конкурентов я формировал самостоятельно.
По конкурентам я собирал не только SEO-показатели
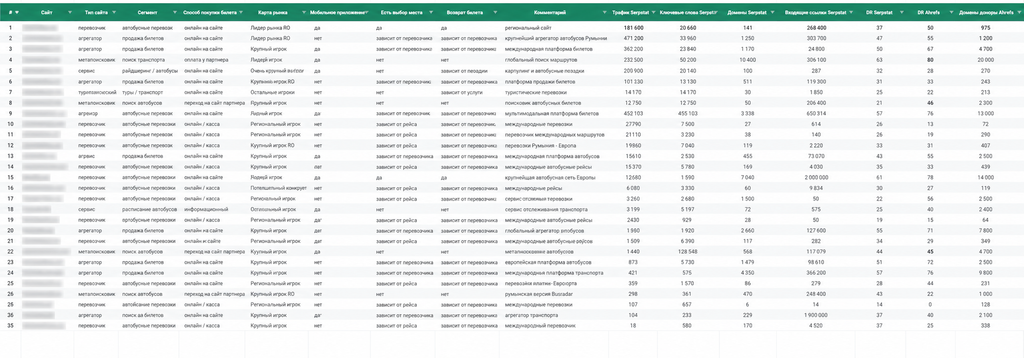
Для анализа я сделал отдельную таблицу.
По каждому конкуренту смотрел тип сайта, сегмент, рынки, способ покупки билета, наличие мобильного приложения, выбор места, возможность возврата билета и другие особенности самого сервиса.
Отдельно собирал данные из Serpstat, Ahrefs и Semrush:
- органический трафик;
- количество ключевых слов;
- ссылочные домены;
- backlinks;
- DR;
- каналы привлечения.
В Semrush дополнительно смотрел рекламную активность конкурентов. Только он и предоставлял такие данные.
В итоге получилась не просто таблица доменов с трафиком и DR. Я мог сопоставлять поисковую видимость с продуктом, рынками и моделью работы конкретного сервиса.
Это давало более полное понимание того, с кем проект будет конкурировать и за какой спрос.
Дальше я выгрузил лучшие страницы конкурентов
Общий органический трафик домена для этой задачи был не самым интересным показателем. Мне нужно было понять, какие конкретно страницы приносят конкурентам поисковый трафик.
Поэтому следующим шагом я выгружал их лучшие страницы.
И здесь уже начали появляться конкретные направления.
Если среди сильных страниц одного конкурента находился маршрут:
Киев → Варшава
я искал такое же направление у других игроков и сравнивал его между несколькими сайтами.
То же самое делал с другими маршрутами:
Львов → Краков
Киев → Берлин
Одесса → Варшава
Киев → Прага
Меня интересовало, какие направления регулярно появляются среди страниц с органическим трафиком у разных конкурентов.
Так я переходил от анализа доменов к анализу конкретных коммерческих страниц.
Семантика помогла определить приоритет маршрутов
Отдельно я исследовал семантику по направлениям и сопоставлял её с данными конкурентов.
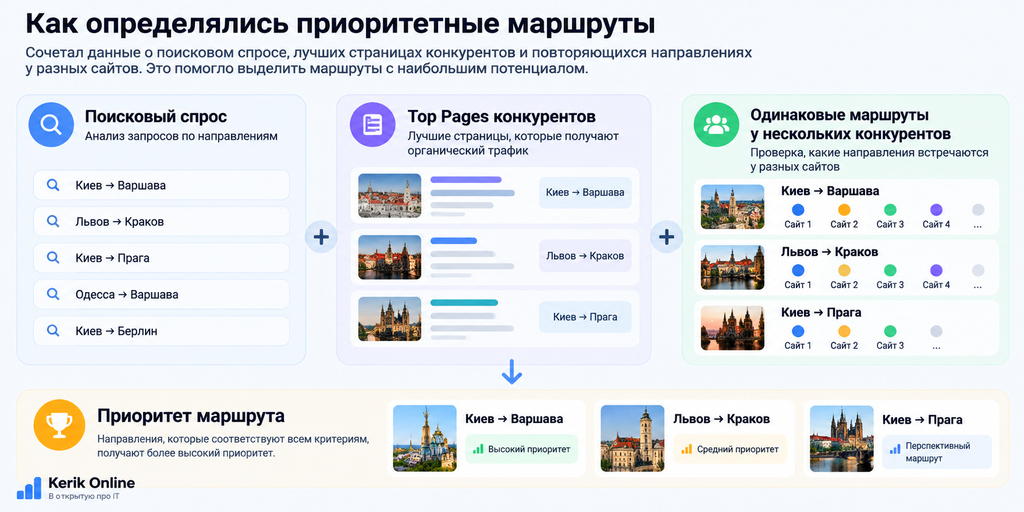
Получалась связка:
поисковый спрос → лучшие страницы конкурентов → одинаковые маршруты у разных сайтов
На основании этого я расставлял приоритеты.
Меня интересовал не только вопрос, какие страницы можно создать для SEO. Нужно было понять, какие направления имеют больший коммерческий потенциал и где потенциально можно быстрее заработать деньги.
Если по маршруту есть поисковый спрос и этот же маршрут получает органический трафик у нескольких конкурентов, такое направление становилось более интересным для дальнейшей работы.
Поэтому семантика использовалась не только для будущих Title, H1 или текстов. Она стала одним из инструментов определения приоритетов развития проекта.
После исследования я перешёл к архитектуре
К этому моменту у меня уже было понимание рынка, реальных конкурентов, сильных страниц и приоритетных направлений.
Теперь можно было проектировать систему.
Исходные данные представляли собой список направлений:
город отправления → город прибытия
Отдельного готового справочника городов на старте не было.
Поэтому в техническом задании я зафиксировал основную модель:
направления первичны, города — производные из направлений.
Из каждого направления система получает город отправления и город прибытия. После этого формируется единый список уникальных городов.
Например:
Киев → Варшава
Варшава → Киев
Львов → Краков
Краков → Львов
Из этих направлений получаем:
Киев
Варшава
Львов
Краков
Эти города становятся отдельными сущностями, которые дальше можно использовать при создании маршрутов.
Сначала нужно было нормализовать города
На реальных данных быстро появляется проблема разных вариантов написания одного города.
Например:
Kyiv
Kiev
Kiyev
Или:
Cologne
Koeln
Köln
Если воспринимать каждое написание как отдельный город, дальше появятся разные сущности, разные маршруты и разные URL для одного и того же направления.
Поэтому за каждым городом закреплялся один основной slug.
Например:
Kyiv → kyiv
Warsaw → warsaw
Lviv → lviv
Krakow → krakow
Для slug я зафиксировал правила:
- один город = один slug;
- slug используется для всех языков;
- slug не переводится;
- используется латиница;
- lower-case;
- дефисы;
- после публикации существующий slug нельзя произвольно менять.
Условно сущность города выглядела так:
city_id → slug_main → локализованные названия
На украинской странице пользователь видит одно название города, на польской или английской — другое. Но city_id и основной slug остаются теми же.
Без этого дальше невозможно было безопасно автоматизировать создание новых маршрутов.
Основным SEO-объектом стал маршрут
После нормализации городов маршрут можно было строить из двух существующих сущностей.
На уровне данных:
from_city_id + to_city_id
На уровне URL:
/bus/{from_slug}-{to_slug}/
Например:
Kyiv + Warsaw
↓
/bus/kyiv-warsaw/
Для остальных языков:
/pl/bus/kyiv-warsaw/
/en/bus/kyiv-warsaw/
/ru/bus/kyiv-warsaw/
Формат URL, регистр и слеш фиксировались заранее, чтобы одна сущность не начинала существовать под несколькими техническими вариантами адреса.
A → B и B → A — разные маршруты
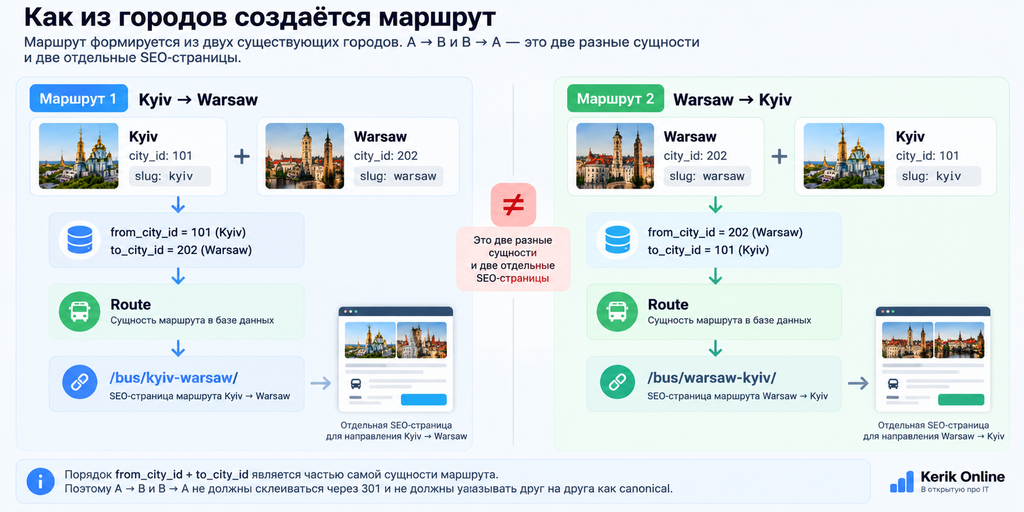
Киев → Варшава и Варшава → Киев — это две разные поездки.
На уровне данных:
Kyiv → Warsaw
и:
Warsaw → Kyiv
На уровне URL:
/bus/kyiv-warsaw/
и:
/bus/warsaw-kyiv/
Это две самостоятельные страницы.
Между ними не нужен 301, и одна страница не должна canonical’ом ссылаться на другую.
Порядок from_city_id + to_city_id является частью самой сущности маршрута.
Все возможные пары городов заранее создавать не нужно
После появления нормализованного справочника технически можно было взять все города и перемножить их между собой.
Но это создало бы огромное количество комбинаций, значительная часть которых могла вообще не иметь спроса.
Именно поэтому я не хотел строить Programmatic SEO по принципу:
есть города → создаём все возможные A × B
Архитектура должна была позволять добавлять новые направления без переделки системы, но само появление маршрута должно иметь основание.
Одним из таких оснований стал реальный пользовательский поиск.
Пользовательский поиск стал одним из источников новых маршрутов
Допустим, пользователь заходит на сайт и ищет:
Киев → Прага
В системе уже существуют две сущности:
Kyiv → kyiv
Prague → prague
Но пары:
Kyiv → Prague
в базе маршрутов ещё нет.
При поиске система проверяет наличие маршрута.
Если его нет, но оба города уже существуют и имеют slug, можно создать новую пару:
from_city_id = Kyiv
to_city_id = Prague
На её основе появляется маршрут:
/bus/kyiv-prague/
То есть новый маршрут создаётся на основании реального действия пользователя.
Вместо того чтобы заранее генерировать все возможные сочетания городов, система получает сигнал: конкретное направление действительно кто-то ищет.
Логика получается такой:
пользователь ищет A → B
↓
проверка существующего маршрута
↓
маршрута ещё нет
↓
A и B существуют
↓
создаётся from_city_id + to_city_id
↓
создаётся маршрут
↓
/bus/a-b/
↓
появляется новая SEO-сущность
Это один из ключевых моментов всей архитектуры.
Сегодня пользователь впервые ищет:
Киев → Прага
Завтра:
Львов → Берлин
Потом:
Одесса → Краков
Если необходимые города уже существуют в системе, новые направления могут появляться без ручного создания каждой отдельной посадочной страницы.
Новый маршрут становится полноценной сущностью
После создания /bus/kyiv-prague/ это уже не временный результат поиска.
Система получает:
from_city_id = Kyiv
to_city_id = Prague
from_slug = kyiv
to_slug = prague
route = Kyiv → Prague
URL = /bus/kyiv-prague/
Дальше маршрут можно обрабатывать по тем же правилам, что и направления, которые находились в первоначальной базе.
Именно здесь появляется связь между пользовательским спросом и Programmatic SEO.
Пользователь помог системе обнаружить новую комбинацию существующих сущностей, а архитектура превратила её в новый маршрут.
Следующая задача — автоматически превратить этот маршрут уже в полноценную SEO-страницу.
Обратное направление остаётся отдельным
Если появился:
/bus/kyiv-prague/
это не означает, что:
/bus/prague-kyiv/
является той же сущностью.
Для обратного направления нужна отдельная пара:
Prague → Kyiv
Поэтому A → B и B → A остаются независимыми направлениями независимо от того, каким способом они появились в системе.
Я отдельно защитил архитектуру от ручных дублей
Автоматизацию можно довольно быстро сломать неправильным ручным наполнением.
Поэтому в ТЗ я отдельно описал создание маршрутов через админку.
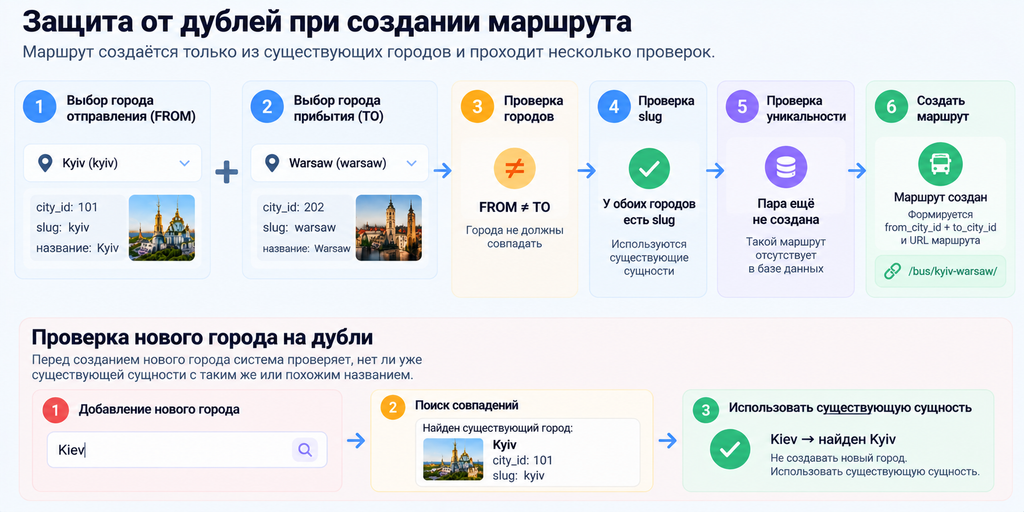
Город отправления и город прибытия выбираются из существующего справочника через выпадающие списки. Ручной ввод названия непосредственно при создании маршрута запрещён.
После выбора городов URL формируется автоматически:
/bus/{from_slug}-{to_slug}/
Перед созданием проверяется:
- города не совпадают;
- оба города существуют;
- у обоих есть slug;
- такая пара ещё не создана.
Это исключает ситуацию, когда один человек создаёт Kyiv → Warsaw, а другой позже вручную заводит тот же маршрут через другое написание города.
Добавление нового города тоже проходит проверку
Если нужного города нет, его можно добавить отдельно.
Но перед созданием система должна нормализовать введённое название, проверить совпадения с существующими городами и уникальность slug.
Если совпадение найдено, администратор должен увидеть существующую сущность и использовать её вместо создания дубля.
Например, если Kyiv уже существует, не нужно создавать ещё один город Kiev только из-за другого написания.
Таким образом, защита от дублей начинается ещё на уровне данных.
Параметры поиска я отделил от маршрута
После выбора направления пользователь может указать дату, количество пассажиров, время или другие параметры.
Например:
/bus/kyiv-warsaw/?date=2026-01-20
или:
/bus/kyiv-warsaw/?passengers=2
или:
/pl/bus/kyiv-warsaw/?date=2026-02-01&time=night
Такие URL нужны самому приложению.
Пользователь может выбрать параметры, скопировать ссылку и отправить её другому человеку с уже выбранным состоянием поиска.
Но для SEO это всё ещё один маршрут:
Kyiv → Warsaw
Поэтому в ТЗ я зафиксировал:
- страницы с параметрами не индексируются;
noindex, follow;- в sitemap они не попадают;
- canonical ведёт на чистый маршрут;
- canonical остаётся внутри текущей языковой версии.
Например:
/bus/kyiv-warsaw/?date=2026-01-20
↓
canonical → /bus/kyiv-warsaw/
Для польской версии:
/pl/bus/kyiv-warsaw/?date=2026-02-01&time=night
↓
canonical → /pl/bus/kyiv-warsaw/
Дата, пассажиры или фильтр меняют состояние поиска, но не создают новую SEO-сущность.
В sitemap должны попадать только чистые маршруты
Из этой же архитектуры следовало правило для sitemap.
В него попадают реальные URL маршрутов:
/bus/kyiv-warsaw/
/bus/kyiv-prague/
/bus/lviv-krakow/
Но не состояния поиска:
?date=...
?passengers=...
?time=...
?filter=...
Страница в sitemap должна существовать и возвращать 200.
Карты сайта также можно разделять по языкам и объединять через sitemap index.
В результате появляется связанная цепочка:
пользовательский спрос
↓
новый маршрут
↓
новая SEO-сущность
↓
чистый URL
↓
дальнейшее подключение к SEO-системе
Подробную автоматизацию sitemap я уже разберу во второй части.
Четыре языка были заложены в архитектуру сразу
Один маршрут мог существовать как:
/bus/kyiv-warsaw/
/en/bus/kyiv-warsaw/
/pl/bus/kyiv-warsaw/
/ru/bus/kyiv-warsaw/
Но в основе это не четыре разных маршрута.
Есть одна пара:
from_city_id + to_city_id
и стабильные slug городов.
Локализация работает поверх этой сущности.
Именно поэтому я не стал переводить slug по языкам. При автоматическом появлении нового маршрута не нужно дополнительно создавать четыре разных идентификатора одних и тех же городов.
Страны и города стали дополнительными уровнями структуры
Кроме маршрутов на сайте существовали страницы стран и городов.
Навигационная модель выглядела примерно так:
страна → город → маршрут A-B → расписание / поиск билета
При этом B-A остаётся самостоятельным направлением.
Страны и города помогают организовать большое количество маршрутов, строить навигацию и дальнейшую внутреннюю перелинковку.
Но основным SEO-объектом остаётся маршрут.
В итоге структура могла расти вместе с реальным спросом
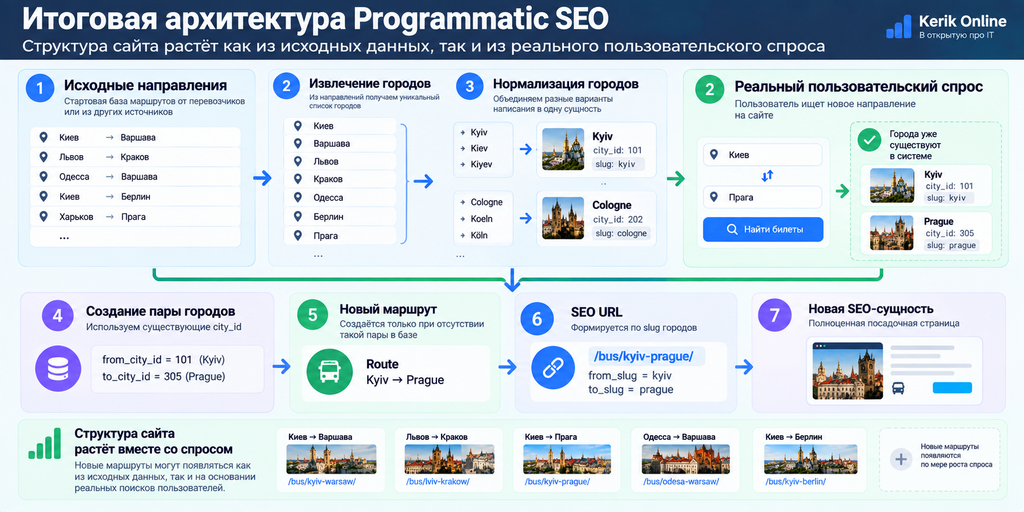
Первоначальная база строилась так:
исходные направления
↓
извлечение городов
↓
нормализация
↓
city_id + slug
↓
from_city_id + to_city_id
↓
маршрут
↓
SEO URL
После запуска появляется ещё один источник новых направлений:
пользователь ищет A → B
↓
маршрута ещё нет
↓
A и B уже существуют
↓
создаётся новая пара
↓
создаётся маршрут
↓
появляется новая SEO-сущность
Именно эту модель я считаю основной идеей Programmatic SEO в этом проекте.
Я не хотел заранее создать максимально возможное количество страниц. Я проектировал систему, которая может расширять SEO-структуру вместе с данными и реальным поведением пользователей.
Эту модель можно перенести на другие транспортные проекты
В автобусном проекте базовая комбинация:
city_from + city_to
Для авиабилетов:
airport_from + airport_to
Для железнодорожных билетов:
station_from + station_to
Для трансферов:
airport + city
Для паромов:
port_from + port_to
Для грузоперевозок и международной доставки:
location_from + location_to
Меняются сущности и данные, но сама механика остаётся близкой.
Особенно интересен сценарий, когда новая комбинация появляется не только после очередного импорта базы, но и на основании реального спроса внутри сервиса.
Создать новый маршрут — только половина задачи
После появления нового маршрута система уже знает:
from_city_id
to_city_id
from_slug
to_slug
язык;
URL.
Но просто создать:
/bus/kyiv-prague/
недостаточно.
Нужно автоматически сформировать Title, Description и H1, собрать текст страницы из шаблонов и реальных данных, настроить canonical и hreflang, создать Schema.org и Open Graph, подключить страницу к sitemap и правильно обработать четыре языковые версии.
Плюс проект работал как SPA. Часть содержимого страницы можно было сформировать сразу, а значительная часть информации о рейсах, ценах и расписании приходила от внешнего источника уже после загрузки.
Поэтому следующий этап моей работы был уже не про создание тысяч URL.
Нужно было сделать так, чтобы каждый новый маршрут автоматически превращался в полноценную SEO-страницу и корректно отдавался поисковой системе.
Об этом — во второй части:
«Programmatic SEO на практике: автогенерация страниц, индексация и SPA».

Связанные материалы
Programmatic SEO на практике: автогенерация страниц, индексация и SPA
В первой части я разобрал, как проектировал архитектуру сайта международных пассажирских перевозок: от анализа рынка и нормализации городов до модели from_city_id +…
Как я использую ChatGPT в SEO на реальном интернет-магазине
Хочу рассказать на реальном примере, как я использую ChatGPT в SEO. Не в формате «напиши мне SEO-текст», а как рабочий инструмент: описания…
Больше практики и наблюдений - в Telegram
Пишу о SEO, рекламе, разработке и AI на примерах из реальных проектов.