Programmatic SEO на практике: автогенерация страниц, индексация и SPA
В первой части я разобрал, как проектировал архитектуру сайта международных пассажирских перевозок: от анализа рынка и нормализации городов до модели from_city_id + to_city_id.
Одна из ключевых особенностей системы заключалась в том, что структура могла расширяться вслед за реальным спросом. Если пользователь искал новое направление между двумя уже существующими городами, система могла создать новый маршрут и получить новый URL:
/bus/kyiv-prague/
Но создать URL — только половина задачи.
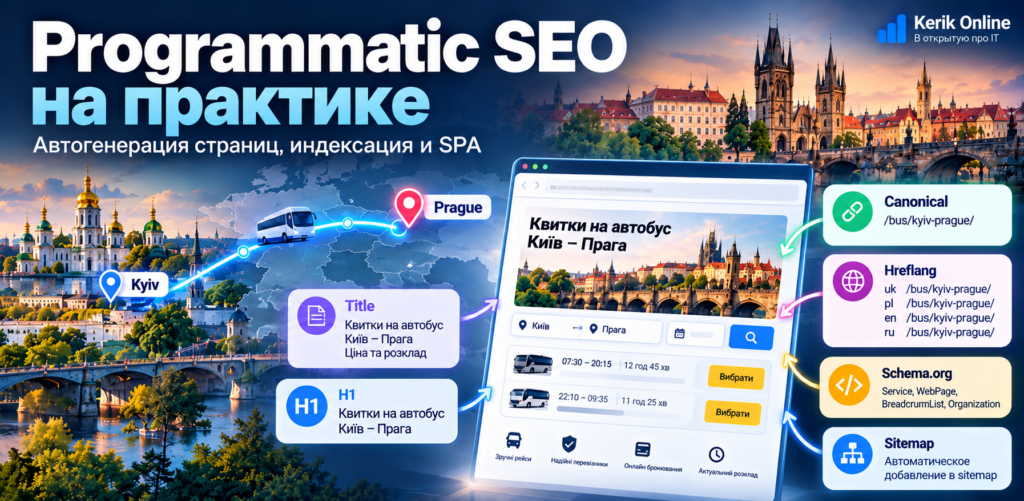
Теперь новый маршрут нужно было автоматически превратить в полноценную SEO-страницу: сформировать метатеги, H1, контент, canonical, hreflang, Schema.org, добавить URL в sitemap и правильно обработать четыре языковые версии.
При этом сам проект работал как SPA, а значительная часть информации о рейсах приходила из внешнего источника. Поэтому автоматизация должна была работать так, чтобы SEO-страница не зависела полностью от того, успели ли загрузиться рейсы, цены и расписание.
Содержание
- Что происходит после создания нового маршрута
- Title, Description и H1 генерируются из данных маршрута
- С текстом страницы задача была сложнее
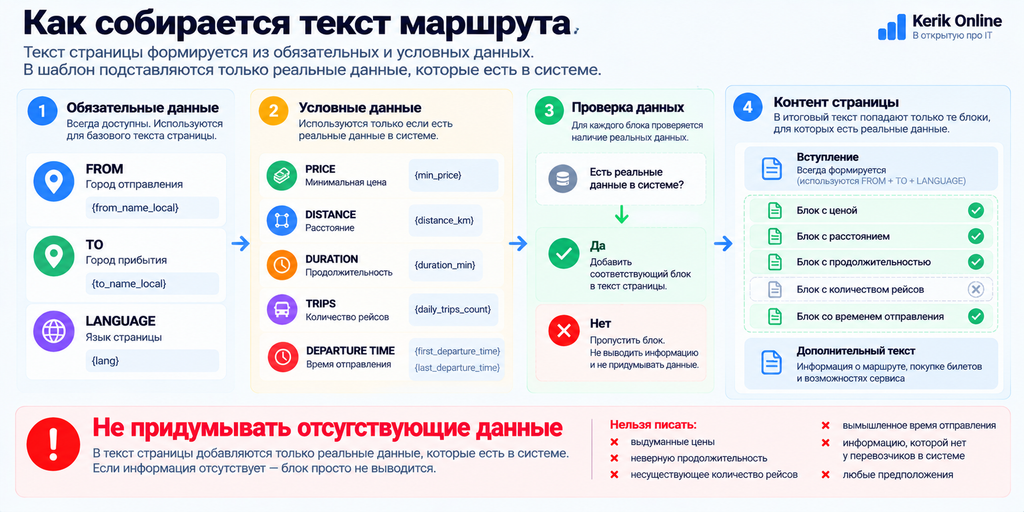
- Для генерации текста я разделил обязательные и динамические данные
- Сам текст тоже собирался блоками
- Canonical строится от чистого маршрута
- Hreflang тоже можно строить автоматически
- Для маршрута нужна единая Schema.org-логика
- Sitemap должен реагировать на появление новых маршрутов
- Страны и города тоже являются частью индексируемой структуры
- Отдельная проблема проекта — SPA
- SEO-страница не должна полностью зависеть от донора
- Это особенно важно для автоматически созданных маршрутов
- Внешний источник не должен определять существование самой страницы
- При масштабировании производительность становится частью архитектуры
- В Programmatic SEO одна ошибка тоже масштабируется программно
- В итоге получилась не система генерации URL
- В этом для меня и заключается Programmatic SEO
Что происходит после создания нового маршрута
Возьмём тот же пример из первой части.
Пользователь ищет:
Киев → Прага
Города уже существуют:
Kyiv → city_id
Prague → city_id
Маршрута ещё нет, поэтому система создаёт новую пару:
from_city_id + to_city_id
После этого появляется:
/bus/kyiv-prague/
На этом этапе у системы уже достаточно данных, чтобы начать автоматически собирать SEO-страницу.
Она знает город отправления, город прибытия, их slug, текущий язык и сам маршрут.
То есть дальше мне не нужно вручную создавать страницу «Киев — Прага», потом отдельно «Львов — Берлин», потом «Одесса — Краков».
Новый маршрут становится входными данными для следующего уровня автоматизации.
Новый маршрут
↓
SEO URL
↓
Title / Description / H1
↓
текст
↓
canonical / hreflang
↓
Schema
↓
sitemap
Именно на этом этапе архитектура из первой части начинает работать как полноценная Programmatic SEO-система.
Title, Description и H1 генерируются из данных маршрута
Для маршрутов я подготовил отдельные шаблоны метатегов для каждого языка.
Например, для украинской версии:
Title: Квитки на автобус {from} - {to} | Ціни та розклад
Description: Квитки на автобус {from} - {to}. Рейси перевізників, розклад руху та актуальні ціни для онлайн-бронювання.
H1: Квитки на автобус {from} - {to}
Для английской:
Title: Bus tickets {from} - {to} | Prices and schedule
Для польской и русской версий использовались свои локализованные шаблоны.
Если появляется маршрут:
Kyiv → Prague
система подставляет локализованные названия городов в шаблон соответствующего языка.
В результате одна сущность маршрута автоматически получает метатеги для всех предусмотренных языковых версий.
При этом URL с параметрами не создают новые варианты метатегов.
Например:
/bus/kyiv-prague/?date=2026-10-20
остаётся тем же маршрутом Kyiv → Prague.
Дата меняет состояние поиска, а не SEO-сущность страницы.
С текстом страницы задача была сложнее
Сгенерировать Title по двум городам довольно просто. С контентом так делать нельзя.
Мне нужно было автоматически создавать описание маршрута, но при этом не придумывать цены, продолжительность поездки, количество рейсов и другие данные, которых в системе может не быть. Поэтому контент я разбил на отдельные блоки.
Первый — короткое вступление под H1. Его задача — сразу объяснить, что находится на странице и что пользователь может сделать.
Ориентировочный объём: 200-320 символов
Основной текст размещается ниже результатов поиска рейсов. Ориентировочный объём: 900-1600 символов
Общий объём текста страницы получался примерно: 1100-1900 символов
Но главное здесь было не количество символов. Главное правило: если фактических данных нет, система не должна их придумывать.
Для генерации текста я разделил обязательные и динамические данные
У каждого маршрута есть набор базовых данных, которые система получает сразу после его создания:
- город отправления —
{from_name_local}; - город прибытия —
{to_name_local}; - slug города отправления —
{from_slug}; - slug города прибытия —
{to_slug}; - текущая языковая версия —
{lang}.
Эти данные доступны для каждого маршрута и используются как основа для автоматического формирования страницы.
На основе этих данных можно сформировать базовое описание маршрута. Дополнительная информация добавляется в текст только в том случае, если она реально есть в системе.
К таким данным относятся:
валюта — {currency}.
расстояние между городами — {distance_km};
продолжительность поездки — {duration_min};
минимальная цена билета — {min_price};
максимальная цена билета — {max_price};
количество рейсов — {daily_trips_count};
время первого отправления — {first_departure_time};
время последнего отправления — {last_departure_time};
Если, например, система не получила реальную минимальную цену, блок с ценой просто не выводится. Если нет достоверной продолжительности поездки — она не вставляется в текст.
Если нет количества ежедневных рейсов — система не должна писать условные «десятки рейсов ежедневно».
Это было принципиально: автоматизация не должна превращаться в массовую генерацию выдуманных фактов.
Сам текст тоже собирался блоками
Я не хотел строить текст страницы на одном шаблоне, в котором меняются только города. Поэтому описание маршрута я разделил на отдельные смысловые блоки, которые система собирает в зависимости от доступных данных.
Обязательным остаётся вступление с информацией о направлении и возможности найти билет. Остальные блоки подключаются по наличию данных:
есть актуальная цена — добавляется информация о стоимости,
есть расстояние и продолжительность поездки — появляется соответствующий блок,
есть данные о рейсах и времени отправления — используются и они.
Отдельные блоки предусмотрены для процесса покупки билета и возможностей самого сервиса.
Для каждой языковой версии я заложил собственные шаблоны. uk, ru, en и pl используют свои языковые конструкции, а не перевод уже сформированного текста с одной версии сайта на другую.
Отдельно учитывал модель самого проекта. Это агрегатор, а не перевозчик, поэтому текст не должен создавать впечатление, что сервис самостоятельно выполняет рейсы.
Canonical строится от чистого маршрута
Параметры мы отделили от SEO-сущности ещё на этапе архитектуры.
Поэтому canonical здесь формируется достаточно просто.
Чистая украинская страница:
/bus/kyiv-prague/
URL с датой:
/bus/kyiv-prague/?date=2026-10-20
Canonical:
/bus/kyiv-prague/
Польская версия:
/pl/bus/kyiv-prague/?date=2026-10-20
Canonical:
/pl/bus/kyiv-prague/
То есть canonical не перескакивает между языками.
Параметры date, passengers, time, filter меняют состояние приложения, но не создают новые SEO-страницы.
Для таких состояний в ТЗ был предусмотрен noindex, follow, а в sitemap они вообще не попадают.
Hreflang тоже можно строить автоматически
Поскольку для города используется единый slug независимо от языка, связать языковые версии одного маршрута можно автоматически. Например, для Kyiv → Prague система формирует четыре URL:
/bus/kyiv-prague//pl/bus/kyiv-prague//en/bus/kyiv-prague//ru/bus/kyiv-prague/
Для них автоматически создаются hreflang со значениями uk, pl, en, ru и x-default. В моём случае x-default указывает на основную украинскую версию.
При этом я заложил важное правило: hreflang связывает только языковые версии одного и того же маршрута. Поэтому Kyiv → Prague связывается со своими версиями на других языках, но не с Prague → Kyiv — это уже отдельная сущность и отдельная SEO-страница.
В hreflang также используются только чистые URL без даты, пассажиров, фильтров и других параметров. В результате после создания пары from_city_id + to_city_id система уже имеет все данные, чтобы автоматически сформировать корректные языковые связи.
Для маршрута нужна единая Schema.org-логика
Следующим этапом я настроил структурированные данные для страниц маршрутов. Здесь я придерживался простого принципа: использовать только те типы Schema.org, которые действительно соответствуют содержимому страницы, а не добавлять разметку ради самой разметки.
Для маршрута использовалась связка:
Service — основная сущность страницы и услуга по поиску билетов на конкретное направление;Organization — информация о самом сервисе;WebPage — описание страницы;BreadcrumbList — её положение в структуре сайта.
Sitemap должен реагировать на появление новых маршрутов
После создания нового маршрута система должна автоматически подключить его к sitemap. Например, пользователь впервые ищет Kyiv → Prague, система создаёт пару from_city_id + to_city_id, появляется /bus/kyiv-prague/, и дальше этот URL уже обрабатывается по общим правилам.
В sitemap попадают только чистые индексируемые страницы маршрутов, которые существуют и возвращают 200. URL с параметрами ?date=, ?passengers=, ?filter= и другими состояниями поиска туда не добавляются.
Для каждого sitemap я установил лимит 4 999 URL. Как только он достигается, система автоматически создаёт следующий файл sitemap и продолжает добавлять новые маршруты уже в него.
Например:
sitemap-routes-1.xml — до 4 999 URLsitemap-routes-2.xml — следующие URLsitemap-routes-3.xml — следующие URL
Все созданные sitemap объединяются через sitemap index. Для мультиязычной структуры их также можно разделять по языковым версиям.
В результате sitemap масштабируется вместе с самим проектом: появился новый валидный маршрут — URL автоматически попал в нужный sitemap, достигнут лимит 4 999 адресов — автоматически создан следующий файл. SEO-специалисту не нужно вручную добавлять новые страницы или следить за заполнением каждого sitemap.
Страны и города тоже являются частью индексируемой структуры
Маршруты были основным направлением Programmatic SEO, но структура не ограничивалась страницами A → B. Я отдельно закладывал страницы стран и городов как самостоятельные точки входа из органического поиска.
Страница страны создавалась под спрос, связанный с автобусными поездками и направлениями в рамках конкретной страны. Например, пользователь мог прийти из поиска не по конкретной паре городов, а по более широкому запросу, связанному с поездками в Польшу, Германию или Чехию.
То же самое с городами. Страница Киева, Варшавы, Праги или Кракова могла самостоятельно собирать поисковый трафик по запросам, связанным с автобусами, билетами и доступными направлениями из конкретного города.
Таким образом, в SEO-структуре было сразу несколько типов посадочных:
страна
город
маршрут A → B
Каждый тип страницы закрывал свой уровень поискового спроса. При этом они связывались между собой внутренней перелинковкой: со страны можно перейти к городам и направлениям, с города — к доступным маршрутам.
Для страниц стран и городов я также предусматривал собственные метаданные и структурированную разметку WebPage и BreadcrumbList. Для городов с видимым блоком вопросов и ответов дополнительно можно было использовать FAQPage.
В итоге страна, город и маршрут — это не просто уровни навигации, а отдельные SEO-сущности, каждая из которых может самостоятельно получать органический трафик.
Отдельная проблема проекта — SPA
Всё описанное выше хорошо выглядит на уровне базы данных. Но сам сайт работал как SPA. И здесь возникала уже другая задача.
Примерно 40% содержимого страницы можно было получить сразу, а около 60% информации зависело от внешнего источника данных.
В первую очередь это касалось:
- рейсов;
- перевозчиков;
- цен;
- времени отправления;
- доступности;
- части данных расписания.
То есть пользователь открывает:
/bus/kyiv-prague/
а приложение после загрузки обращается к внешнему источнику и получает актуальные предложения.
Для пользователя такая модель может работать нормально.
Для SEO появляется вопрос: что именно получает поисковая система до того, как внешний источник ответил?
SEO-страница не должна полностью зависеть от донора
Здесь я разделял постоянную сущность маршрута и динамические данные рейсов.
У маршрута уже есть информация, которая не зависит от внешнего ответа:
from_city_id
to_city_id
локализованные названия городов;
slug;
URL;
Title;
Description;
H1;
canonical;
hreflang;
breadcrumbs;
базовая Schema;
часть текста;
внутренние ссылки.
А есть динамическая информация:
цены;
конкретные рейсы;
перевозчики;
время отправления;
наличие билетов.
Эти данные могут обновляться через API уже после загрузки.
Так SEO-страница не превращается в пустой контейнер только потому, что внешний источник отвечает медленно или временно недоступен.
Это особенно важно для автоматически созданных маршрутов
Вернёмся к /bus/kyiv-prague/.
Маршрут только что появился на основании пользовательского спроса.
Если его страница существует исключительно как пустой SPA-контейнер, а всё содержимое появляется только после нескольких запросов JavaScript, само наличие красивого URL ещё ничего не решает.
Поэтому при масштабировании я смотрел не только на количество созданных страниц.
Важно, чтобы поисковая система могла получить нормальное представление о самой сущности маршрута независимо от динамической части.
Для такого проекта логично выносить стабильный SEO-слой из зависимости от внешних данных и по возможности отдавать его сразу.
SSR или prerendering здесь уже становятся техническими вариантами реализации этой задачи, а не самоцелью.
Главное — не способ рендеринга как таковой, а результат: поисковая система должна стабильно получать содержимое страницы маршрута.
Внешний источник не должен определять существование самой страницы
Есть ещё один важный момент. Если сегодня внешний источник временно не вернул рейсы, это не обязательно означает, что сущность:
Kyiv → Prague
перестала существовать.
Маршрут уже есть в архитектуре сайта.
Поэтому временная проблема с получением динамических данных не должна автоматически превращать валидную страницу маршрута в случайный 404 или пустую страницу без SEO-содержимого.
Статус самой SEO-сущности и текущая доступность рейсов — разные вещи.
Это особенно важно для большой программной структуры, где один внешний сбой иначе может одновременно затронуть огромное количество посадочных страниц.
При масштабировании производительность становится частью архитектуры
Когда страниц несколько десятков, некоторые технические проблемы можно долго не замечать.
Когда их тысячи, одна ошибка начинает повторяться на всей структуре.
То же самое касается производительности.
Если каждая маршрутная страница загружает тяжёлые изображения, лишние JS-зависимости и ждёт несколько внешних запросов, проблема масштабируется вместе с количеством страниц.
Поэтому изображения я отдельно переводил в WebP.
Для автоматической обработки изображений закладывал:
- конвертацию в WebP;
- сжатие;
- изменение размеров под реальное отображение;
- кэширование;
- сохранение оригинала как fallback при необходимости.
Особое внимание здесь нужно уделять элементу, который становится LCP.
Но одними изображениями проблему SPA не решить.
Нужно отдельно смотреть объём JavaScript, сторонние скрипты и всё, что блокирует первоначальный вывод полезного содержимого.
В Programmatic SEO одна ошибка тоже масштабируется программно
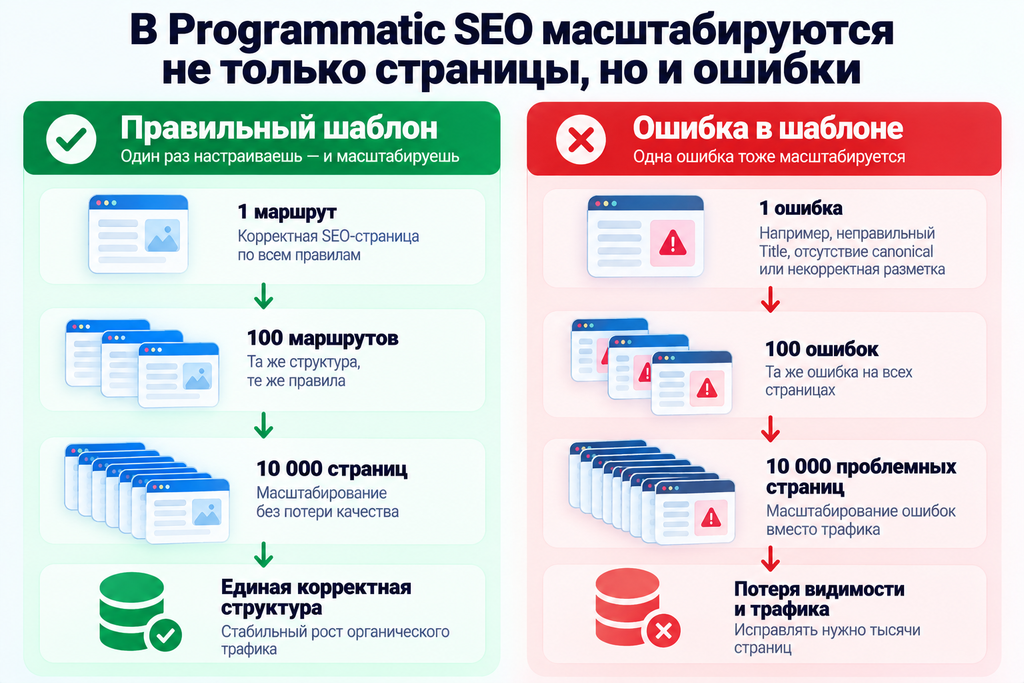
Это, пожалуй, одна из главных особенностей такой архитектуры. Если неправильно сделан один Title-шаблон, ошибка появляется не на одной странице. Она появляется на тысячах.
Если неправильно настроен canonical — проблема масштабируется.
Если hreflang связывает неправильные сущности — проблема масштабируется.
Если sitemap принимает технические URL — они начинают массово попадать в карты сайта.
Если шаблон текста придумывает отсутствующую цену — вы получаете выдуманные данные уже не на одной странице, а по всей структуре. Поэтому перед масштабированием я фактически проектировал не страницы. Я проектировал правила создания страниц.
Именно качество этих правил определяет, что получится после появления тысяч URL.
В итоге получилась не система генерации URL
Если посмотреть на весь процесс целиком, он начинается намного раньше автоматического Title или sitemap.
Сначала появляется нормализованная модель данных:
город
↓
city_id + slug
Потом:
from_city_id + to_city_id
↓
маршрут
После этого:
маршрут
↓
SEO URL
↓
метатеги
↓
контент
↓
canonical
↓
hreflang
↓
Schema
↓
sitemap
↓
индексируемая посадочная
И параллельно SPA может подгружать динамические данные:
рейсы
цены
перевозчиков
расписание
При этом новый маршрут может появиться не только из первоначальной базы, но и вслед за реальным пользовательским спросом.
В результате структура способна расширяться без ручного создания каждой новой страницы.
В этом для меня и заключается Programmatic SEO
Не в том, чтобы сгенерировать 100 000 URL. И не в том, чтобы взять один текстовый шаблон и заменить в нём названия городов. В этом проекте Programmatic SEO получилось связкой:
данные → сущности → спрос → новые комбинации → маршруты → SEO-правила → автоматические страницы
Сначала я спроектировал систему, которая понимает, что является страницей. Потом — правила, по которым эта страница автоматически получает всё необходимое для SEO. И только после этого имеет смысл масштабировать количество маршрутов.
Потому что если архитектура правильная, новый маршрут:
Kyiv → Prague
для SEO уже не является отдельной ручной задачей.
Он становится ещё одной сущностью, которую система умеет обработать по заранее заданным правилам.

Связанные материалы
Programmatic SEO с нуля: как я спроектировал структуру сайта на тысячи посадочных страниц
Проект - сервис международных пассажирских перевозок между городами Украины и Европы. Важный момент: часть изображений и данных в этом кейсе будет заменена…
Как я использую ChatGPT в SEO на реальном интернет-магазине
Хочу рассказать на реальном примере, как я использую ChatGPT в SEO. Не в формате «напиши мне SEO-текст», а как рабочий инструмент: описания…
Больше практики и наблюдений - в Telegram
Пишу о SEO, рекламе, разработке и AI на примерах из реальных проектов.